系统不稳的时候,最先缺的往往不是一张更漂亮的大盘,而是一句能反复问的话:现在慢在哪、积压了多少、刚开始吐字要多久。接口 p99、队列消费时间、TTFT,都得先落成带时间戳的数。
Prometheus 干的就是这件事。它按固定间隔去拉 /metrics,把结果写成时间序列,再用 PromQL 查询和告警。Grafana 不存这些数,只负责把查询画出来。Alertmanager 不判断表达式,只负责分组、抑制、静默和通知。
谁拉、谁存、谁看
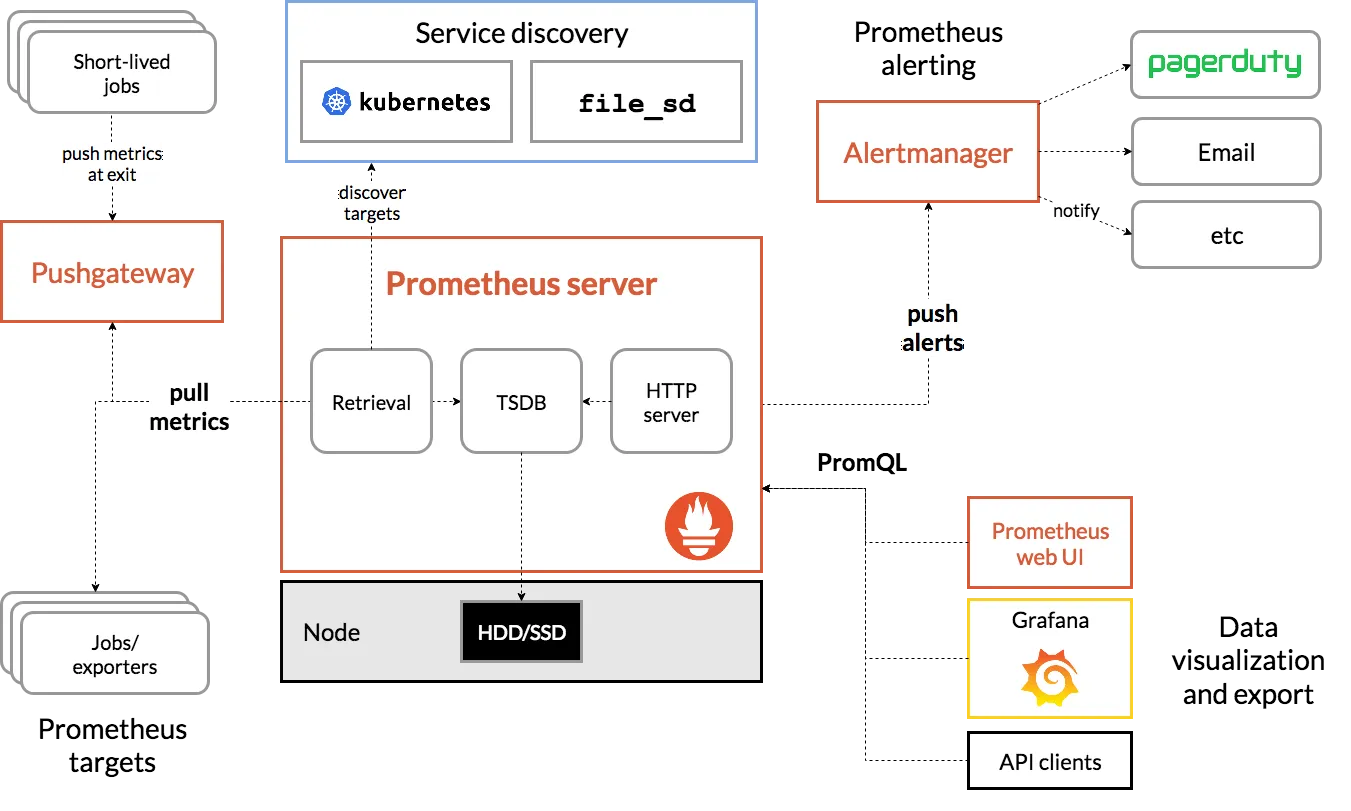
Prometheus 是 pull 模型。长期活着的服务自己暴露 /metrics,由 Prometheus 来扫。短任务活不过一次 scrape,才把最后一次指标推到 Pushgateway,再被 scrape。
官方架构是这张图。服务发现、Retrieval、TSDB、Alertmanager、Grafana 都在上面,后面拆开的图都对照它读。
拆开看,采集、存储、查看和告警是三块:
核心组件就这些:
- Prometheus server:服务发现、scrape、TSDB、PromQL、评估告警规则
- client library:在业务代码里埋 Counter / Gauge / Histogram
- exporter:给自己不会暴露
/metrics的东西补一层(主机、中间件) - Pushgateway:短任务的中转,不是默认入口
- Alertmanager:告警的分组、抑制、静默、路由
- Grafana:PromQL 的视图,带变量和权限
一次 scrape 长这样:

目标列表来自静态配置、文件或 Kubernetes 服务发现。Prometheus 对每个 target 发 GET /metrics,把 exposition 文本解析成 sample,按 series 追加进本地 TSDB。目标挂了只表现为这次 scrape 失败,不会把采集链路一起拖死。
scrape_interval 决定分辨率。官方默认常是 1m;看延迟时很多人改成 15s。scrape_timeout 必须小于间隔,否则下一轮会叠上来。
一条时间序列长什么样
时间序列由固定的 metric name + labels 标识,上面挂着一组 (timestamp, value)。
http_requests_total{job="api", method="GET", code="200"}这是一条 series,不是一张表。http_requests_total 是 metric family;job / method / code 是 label。PromQL 的选择和聚合都靠 label。
Label 多一个取值,series 就多一条。user_id、request_id、无界的 URL 路径不能当 label,否则 cardinality 会把 TSDB 和查询一起打满。该留的是有限集合:job、instance、method、code、handler。
样本是某个时间点的一个值。Prometheus 通常在 scrape 时打时间戳,应用一般不用自己写时间。
四种 metric,对应四种问法
Counter
只能加,进程重启归零。用来记次数、累计字节。
图上不要直接画原始 Counter,画速率:
rate(http_requests_total[5m])过去一段时间增加了多少:
increase(http_requests_total[1h])rate 适合画图;increase 适合「上一小时多了多少」。窗口至少覆盖 2 个 scrape,5m 是常用起步。
var reqs = prometheus.NewCounterVec(
    prometheus.CounterOpts{
        Name: "http_requests_total",
        Help: "Total HTTP requests",
    },
    []string{"method", "code"},
)
Gauge
可上可下,记录当前值。并发、内存、队列长度、温度走这里。
var memUsage = prometheus.NewGauge(prometheus.GaugeOpts{
    Name: "process_memory_bytes",
    Help: "Current memory usage in bytes",
})
memUsage.Set(float64(bytes))
队列积压就是 Gauge。告警看绝对值或斜率,不要对 Gauge 套 rate()。
Histogram
把观测值丢进预先定好的 bucket,导出 _bucket、_sum、_count。Prometheus 不存现成的 p99,查询时用 histogram_quantile 按桶估算。
histogram_quantile(
  0.99,
  sum(rate(http_request_duration_seconds_bucket[5m])) by (le)
)
le 是桶上界,聚合时必须带着。服务端延迟、请求体大小,尤其是要跨实例看整体分位,用 Histogram。
var reqDuration = prometheus.NewHistogramVec(
    prometheus.HistogramOpts{
        Name:    "http_request_duration_seconds",
        Help:    "Request duration seconds",
        Buckets: prometheus.DefBuckets,
    },
    []string{"handler", "method"},
)
DefBuckets 是 5ms 到 10s 的一组通用桶。接口 p99 若在 200ms 附近,这组桶太稀。按真实延迟选对数或倍数桶:太少则分位糊,太多则 series 膨胀。
Summary
在客户端算分位,同时导出 _sum、_count。每个实例自己的 sliding window 不能在服务端精确合并。要跨实例看整体 p99,不要只用 Summary,用 Histogram。
Summary 适合「只关心这一台机器上的分位」。
var reqSummary = prometheus.NewSummaryVec(
    prometheus.SummaryOpts{
        Name:       "http_request_duration_seconds_summary",
        Help:       "Request duration summary",
        Objectives: map[float64]float64{0.5: 0.05, 0.9: 0.01, 0.99: 0.001},
    },
    []string{"handler"},
)
名字里已经有 http_request_duration_seconds 时,不要再给 Summary 复用同一个 metric name。
PromQL:先会这几下
选一条 series:
http_requests_total{job="api", code="500"}按秒的成功率:
sum(rate(http_requests_total{code=~"2.."}[5m]))
/
sum(rate(http_requests_total[5m]))
TTFT、排队时间同样是 Histogram,把名字换成对应的 _bucket 即可。irate 只用窗口里最后两个点,毛刺大;面板默认用 rate。
同一条查询不要在 Grafana 里写三遍。稳定且贵的聚合做成 recording rule,把结果物化成新 series,告警和面板都读它。
Grafana 不存指标
Grafana 向 Prometheus 发 PromQL,把返回值画成折线、热力图、单值。权限、变量、模板是给人和面板复用的,不改变 TSDB 里有什么。
所以采集错了,换仪表盘救不回来。先把 Counter / Histogram 埋对,再谈面板。
服务级指标可以按 RED 收:Rate、Errors、Duration。主机和中间件按 USE 收:Utilization、Saturation、Errors。两套问法不同,不要用同一张图硬套。
告警:规则在 Prometheus,派发在 Alertmanager
规则是 PromQL 加持续时间。例如 5xx 比例持续 5 分钟高于阈值,才进入 firing。Prometheus 把 firing 推给 Alertmanager。
Alertmanager 做三件事:
- 分组:同一
alertname+service在短时间里并成一条通知 - 抑制:更严重的告警压住它的下游症状
- 静默:维护窗口里不要叫人
通知渠道(邮件、IM、值班)只接 Alertmanager,不要让 Grafana 面板按钮当唯一告警路径。面板是给人看的,告警是给值班的。
落地时先钉住的几件事
- 先埋 RED,再铺主机。 没有请求速率和延迟,CPU 再漂亮也定位不了接口。
- label 必须有界。 高基数先表现为内存和 compaction,再表现为查询超时。
- Histogram 的桶按真实分布定。 抄
DefBuckets再看 p99,误差会大到不能当 SLO。 - 短任务才用 Pushgateway。 长期服务走 pull。Pushgateway 里的 series 不会因为任务结束自动消失,要自己管生命周期。
- 单实例 Prometheus 有上限。 本地 TSDB 适合一个团队的起步。要长期、多集群、无限基数,再考虑远端写和专用长期存储,不要第一步就上。
可以抄的起步值:全局 scrape_interval: 15s(延迟敏感)或 1m(主机类);scrape_timeout 取间隔的 90%;本地 retention 15 天;业务 Histogram 按 P50/P99/P99.9 附近加密。
案例:主机 TCP 能看到什么
背景里的队列和 TTFT 走业务 Histogram。主机 TCP 是另一层:连接状态、吞吐、重传。node_exporter 已经暴露了其中大部分,不必先写一个自定义 exporter。
主机级、能直接用的:
| 你想看的 | 常见 series | 类型 |
|---|---|---|
| 当前 ESTABLISHED | node_netstat_Tcp_CurrEstab |
Gauge |
| TIME_WAIT | node_sockstat_TCP_tw |
Gauge |
| 使用中的 TCP 套接字 | node_sockstat_TCP_inuse |
Gauge |
| 主动 / 被动打开 | node_netstat_Tcp_ActiveOpens / Tcp_PassiveOpens |
Counter |
| 收发字节 | node_network_receive_bytes_total / transmit_bytes_total |
Counter |
| 重传段 | node_netstat_Tcp_RetransSegs |
Counter |
| 发出段 | node_netstat_Tcp_OutSegs |
Counter |
| 建连失败 / 复位 | node_netstat_Tcp_AttemptFails / Tcp_EstabResets |
Counter |
当前连接和 TIME_WAIT:
node_netstat_Tcp_CurrEstab
node_sockstat_TCP_tw
每秒新建(主动 + 被动):
rate(node_netstat_Tcp_ActiveOpens[5m])
+
rate(node_netstat_Tcp_PassiveOpens[5m])
网卡吞吐:
rate(node_network_receive_bytes_total[5m])
rate(node_network_transmit_bytes_total[5m])
重传率(段数比,不是精确丢包率):
rate(node_netstat_Tcp_RetransSegs[5m])
/
rate(node_netstat_Tcp_OutSegs[5m])
node_exporter 看不到 的,不要假装已经有了:
- 按连接拆开的 SYN_SENT / CLOSE_WAIT / LISTEN 细表。sockstat / netstat 是主机汇总,不是
ss那样的逐连接清单 - 单条连接的 RTT、握手耗时、逐流丢包。那是 eBPF / 抓包的场,不是
/metrics扫一次能得到的
CLOSE_WAIT 堆积、SYN 队列溢出,需要 ss 采样、conntrack 或专门的网络 exporter。先把上表画出来,通常已经够判断「这台机器连接是不是在漏、是不是在重传」。单连接诊断再加下一层,不要和 scrape 混成一条链路。
可以改数字,不要改模型
15 秒还是 1 分钟、桶怎么切、retention 留几天,以后几乎一定要改。不该改的是:长期服务用 pull;短任务才 push;Grafana 不拥有数据;告警表达式和通知路由分开;label 保持有界;跨实例分位用 Histogram。
先让 p99、积压、TTFT、TCP 重传能被同一套 PromQL 问出来。大盘是这之后的事。