这篇说明 Langfuse 自托管的两个进程、四套存储、一次写入和一次读取,以及一套 Langfuse 4.4.0 实例怎样做高可用。
适合要读 trace,或要判断这套共享实例边界的工程师。部署命令和现网地址不在这里。
先看「两个进程和四套存储」,再看「一次写入」。高可用和容量对应 2026-10-09 对这套实例的只读观察:官方 Helm chart 1.5.41,镜像标签 4.4.0。组件分工引自 Langfuse 自托管说明,扩容差异引自 扩容说明。
记下来的对象
Langfuse 记下一次大模型调用的输入、输出、耗时和 token,以及调用之间的嵌套。查询单位是 observation。同一个 trace_id 把相关 observation 收在一起。
对象可以这样记:
- trace 是一次任务或一次对话的关联 ID。
- observation 是其中的一步,类型是 span、generation 或 event。一次模型调用、一次工具调用各是一行。
- score 是对某次结果的评价。
- session 把多条 trace 归到同一次会话。
- prompt 是提示词原文,放在 PostgreSQL;热的读穿缓存放在 Redis。
v3 的基础设施演进把观测数据从 PostgreSQL 挪到 ClickHouse。ClickHouse 原地更新一行很贵,所以更新被做成再次插入。
v4 升级说明把读路径改成以 observation 为中心的宽表。基础设施没有多出一个进程,仍是 Web、Worker、PostgreSQL、ClickHouse、Redis 和 S3。
v4 用两张 ClickHouse 表替换 traces 和 observations 的读路径:
| 表 | 放什么 | 谁来读 |
|---|---|---|
events_full |
完整的一行。用户、会话、标签、release、version 直接写在这行上 | 要看完整输入和输出的单条查询 |
events_core |
events_full 的轻量投影,大字段被截断,由物化视图写入 |
列表和图表 |
trace 不再是单独的一行,而是同一张表里的根 span。旧数据里的 trace 会变成类型为 SPAN、span ID 为 t-<trace_id> 的虚拟根 span,历史记录仍能打开。界面默认只显示根 observation,一行对应以前的一条 trace;去掉这个过滤才看到全部 observation。原先挂在 trace 上的 score 和评论,显示在对应的根 observation 上。score 的配置仍在 PostgreSQL,和用户、项目、prompt、dataset 一起,不跟着观测行搬家。
2026-03-10 的文章把这次改表画成下面这张图。左边是 v3,traces 和 observations 两张可变表,查询要 join。右边是 v4,原先在 trace 上的 user_id、session_id 和 trace metadata 写到 observation 行上。
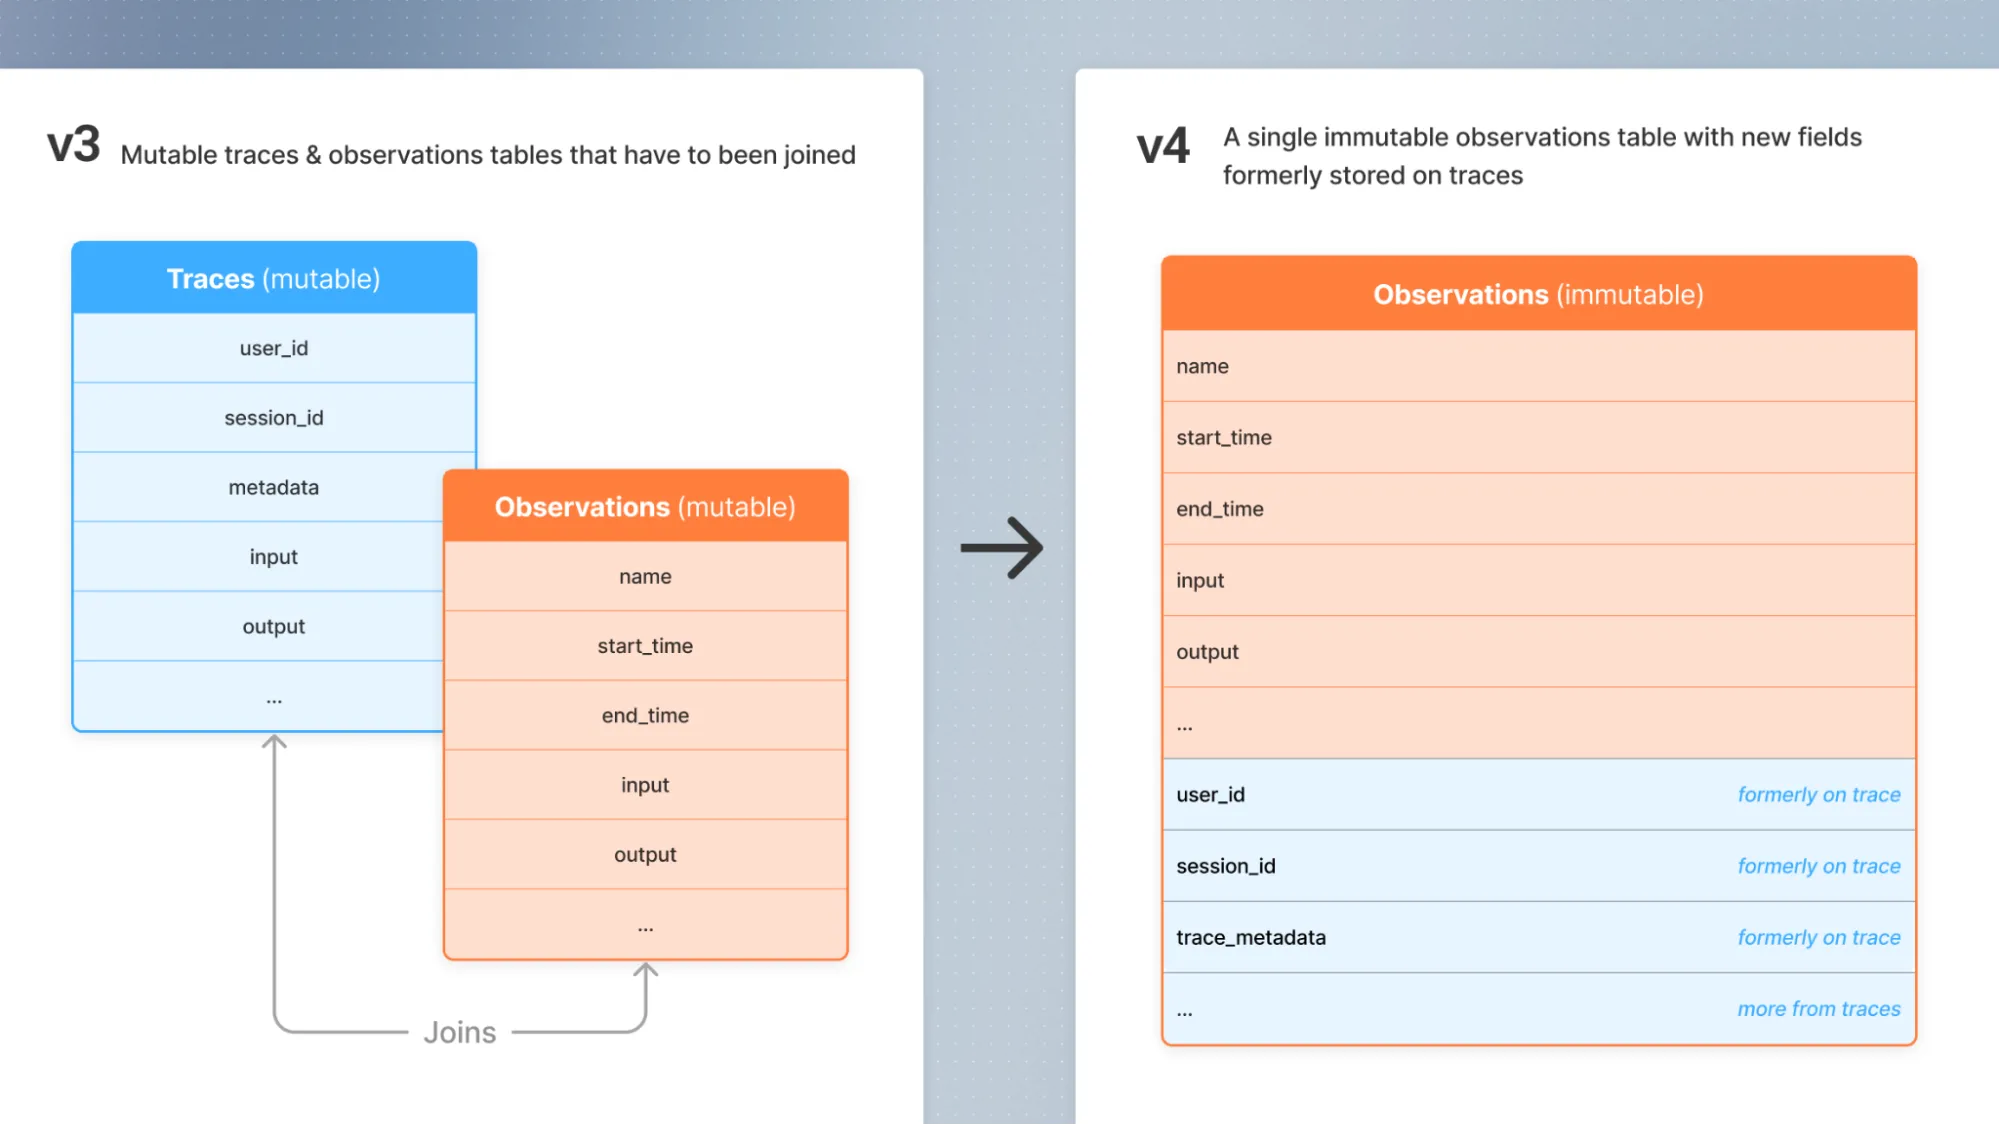
图把 v4 画成一张 observation 表。这套实例的镜像是 4.4.0,全文在 events_full,列表和图表读物化视图 events_core。
Langfuse Cloud 的公开材料里,截至 2026 年 3 月,大约 60% 的 observation 从 OpenTelemetry 端点进入,这类 span 按不可变行写入。这不是这套实例的测量。
工程说明记录了 v3 的合并原因:大约 90% 的更新会在 10 秒内到达,于是在 Worker 里把多次事件收成一行,而不是在 ClickHouse 里改已有行。这个比例只属于当时的 Cloud。
数据放在哪一张表,和请求先碰到哪个进程,是两件事:
flowchart LR
  obs["observation"] --> full["events_full 全文"]
  full --> core["events_core 列表与图表"]
  meta["用户、项目、prompt、score 配置"] --> pg["PostgreSQL"]
  hot["API key 与热 prompt"] --> redis["Redis"]
两个进程和四套存储
对外只有 Web。UI、登录、公开 API、摄入和媒体上传都打到 langfuse-web。Worker 没有 Service,容器端口 3030 只给存活探针 GET /api/health。
两个进程不互相调用。交接物是 Redis 里的队列消息,消息带的是 S3 对象引用,原始事件在对象存储里。
自托管说明里的部署图如下。调用方只连 Web。Web 连 PostgreSQL、Redis / Valkey、ClickHouse 和 S3。Redis 把任务交给 Worker,Worker 再连 PostgreSQL、ClickHouse 和 S3。可选的 LLM API 画在 Web 的 playground 和 Worker 的评估上。
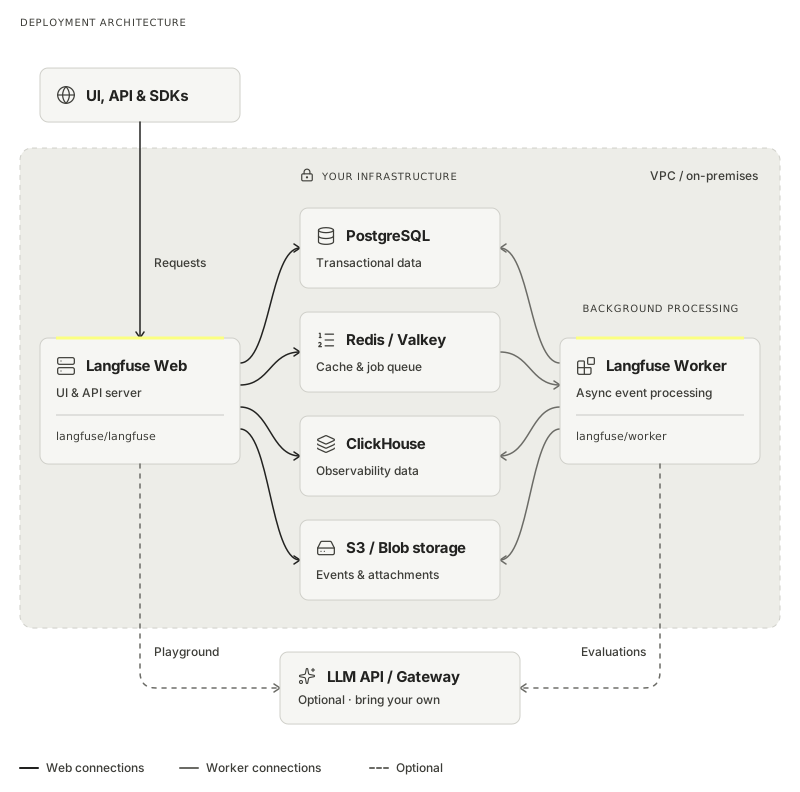
这套实例把四套存储放在集群外。调用方只到 Web。Web 写原始事件和引用,Worker 再写 ClickHouse:
flowchart LR
  client["调用方"] --> web["Web"]
  web --> s3["S3 原始事件"]
  web --> redis["Redis 引用"]
  redis --> worker["Worker"]
  worker --> s3
  worker --> ch["ClickHouse"]
  web --> pg["PostgreSQL"]
  worker --> pg
  web -.->|未配置| llm["LLM 网关"]
  worker -.->|未配置| llm
Web 和 Worker 带着同一组存储环境变量,所以 Web 也能写 ClickHouse,Worker 也能读 PostgreSQL。差别是谁站在调用方的这次 HTTP 上。读查询从 Web 发出,摄入后的合并和批量插入从 Worker 发出。
| 存储 | 这套实例 | 放什么 |
|---|---|---|
| PostgreSQL | 集群外的 RDS。自动迁移开着 | 用户、组织、项目、API key、prompt、score 配置、媒体上传状态 |
| Redis | Serverless,集群模式,TLS,库号 0,用户名和口令都空 | 队列,以及 API key 和热 prompt 的缓存 |
| ClickHouse | ClickHouse Cloud 上的一个库。CLICKHOUSE_CLUSTER_ENABLED=false,应用只连一个地址。自动迁移开着,迁移连接使用 SSL |
observation 行。列表读 events_core,全文读 events_full |
| S3 | 集群外的一个桶。path-style 关闭。事件、媒体、批量导出共用这个桶和同一对访问密钥 | 原始事件、多模态对象、导出文件 |
集群内的 ClickHouse、PostgreSQL、Redis 和 MinIO 都不渲染。数据是否还在,取决于这四套托管服务,不取决于 Langfuse 的 Pod 还在不在。
可选的 LLM 网关在官方图里有两个用途:Web 上的 playground,Worker 上的评估。这套实例的 Pod 环境里没有单独的 LLM 网关地址。代码评估走的是另一条路,见下一节。
官方图卡片上的 Worker 写成 langfuse/worker。这套实例拉的是 Docker Hub 上的 langfuse/langfuse:4.4.0 和 langfuse/langfuse-worker:4.4.0。新 Pod 拉镜像依赖 Docker Hub,不依赖账号里的镜像仓库。
一次写入
SDK 的批量摄入打 POST /api/public/ingestion。OpenTelemetry 打 /api/public/otel,官方写入端点是 POST /api/public/otel/v1/traces。两条都只进现有的这组 Web,没有按路径再拆一组 Pod。
一次摄入里,HTTP 返回和查询可见是两个时刻:
sequenceDiagram
  participant SDK as 调用方
  participant Web as Web
  participant Redis as Redis
  participant PG as PostgreSQL
  participant S3 as S3
  participant Worker as Worker
  participant CH as ClickHouse

  SDK->>Web: POST 摄入或 OTel
  Web->>Redis: 查 API key
  alt 缓存未命中
    Web->>PG: 读 API key
    PG-->>Web: 身份
  end
  Web->>S3: 写入原始事件
  Web->>Redis: 放入引用
  Web-->>SDK: HTTP 返回
  Note over SDK,CH: 返回时 ClickHouse 里还没有合并后的行
  Worker->>Redis: 取出引用
  Worker->>S3: 读取原始事件
  Worker->>CH: 读取同一条旧行
  Note over Worker: 在内存里合并并攒批
  Worker->>CH: 批量插入
| 阶段 | 在哪 | 调用方此时 |
|---|---|---|
| 鉴权 | Web。API key 先查 Redis,未命中再查 PostgreSQL | 未授权的请求在这里结束 |
| 写原始事件 | Web 写 S3。事件上传开着 | 还在同一次 HTTP 里 |
| 入队 | Web 向 Redis 放入 S3 引用 | 入队之后 HTTP 返回。这一刻 ClickHouse 里还没有合并后的行 |
| 合并 | Worker 从 S3 取出事件,默认再读 ClickHouse 里同一条旧行,和这次事件合并 | 查询 API 仍可能看不到 |
| 插入 | Worker 先放进内存缓冲,按批次写入 ClickHouse。官方工程说明里,ClickHouse 侧还可以再做 async_insert |
刷写完成之后,下一次读才能看到 |
扩容说明写明:Worker 默认会读 ClickHouse 里的已有行再合并。全量历史已经在 S3 里、且项目不是从旧版本迁来时,这个读可以跳过,变量是 LANGFUSE_SKIP_INGESTION_CLICKHOUSE_READ_MIN_PROJECT_CREATE_DATE。这套实例没有设置这个变量,所以合并时的 ClickHouse 读还在。
插入和查询用的是同一个地址。环境变量里没有 CLICKHOUSE_READ_ONLY_URL,只有 CLICKHOUSE_URL。官方把只读地址用于把分析查询和插入分开,主要面向 ClickHouse Cloud 这种计算和存储分离的部署。这套实例没有拆。
原始事件先于队列写入 S3。Worker 在 HTTP 返回之后失败时,已接收的事件仍在桶里。官方说明据此可以重放,不依赖客户端再发一次。
另一类写入不进摄入队列:
flowchart TD
  record["项目、用户、API key、prompt"] --> pg["PostgreSQL"]
  media["媒体上传"] --> s3["S3"]
  media --> pg
  exportJob["批量导出"] --> s3
  codeEval["代码评估"] --> worker["Worker 进程"]
| 请求 | 路径 |
|---|---|
| 项目、用户、API key、prompt | Web 直接写 PostgreSQL。热 prompt 的读穿缓存放在 Redis |
| 媒体 | Web 接 /api/public/media,文件进同一个 S3 桶。上传状态按内容哈希记在 PostgreSQL。单对象上限 1e9 字节,下载链接有效期 3600 秒 |
| 批量导出 | LANGFUSE_S3_BATCH_EXPORT_ENABLED=true。导出文件进同一个桶,由后台任务写 |
| 代码评估 | LANGFUSE_CODE_EVAL_DISPATCHER=insecure-local,队列消费者开着。TypeScript 或 JavaScript 在 Worker 进程里跑,不在 SDK 那次 HTTP 里 |
三类对象共用一个桶。官方不建议对媒体桶做按时间删除:trace 里的引用会断,同一文件再传也会失败,因为上传状态按哈希记在 PostgreSQL。事件可以按保留期清理,媒体要和事件分开看。这套实例没有把它们拆到不同的桶。
一次读取
列表、详情和公开查询 API 都在 Web 上结束。Worker 不参与这次 HTTP。
读请求按对象分到四套存储,不到 Worker:
flowchart TD
  req["读请求"] --> web["Web"]
  web --> ch["observation 行在 ClickHouse"]
  web --> redis["API key 与热 prompt 在 Redis"]
  web --> pg["用户、项目、prompt 原文在 PostgreSQL"]
  web --> s3["媒体是 S3 下载链接"]
| 读什么 | 先碰到 | 主体数据 |
|---|---|---|
| 列表和图表 | Web 查 ClickHouse 的 events_core |
行由 Worker 早先的批量插入写成,再由物化视图投影 |
| 单条的完整输入和输出 | Web 查 events_full |
同一条写入路径。HTTP 刚返回时,这行可能还没有 |
| API key | Redis | 未命中则读 PostgreSQL |
| prompt | Redis 读穿缓存 | PostgreSQL |
| 媒体 | Web 签发 S3 下载链接 | 对象在同一个桶,链接有效期 3600 秒 |
| 登录会话 | Web 走飞书 OIDC | 用户和组织在 PostgreSQL。登录回调只到 Web |
慢查询时,先看 ClickHouse 的资源和时间过滤。观测数据按项目和时间建索引,加上这两项条件通常比先加机器有效。过滤已经加上仍然慢,再加大 ClickHouse 的内存。官方对较大部署的建议是至少 16 GiB。这套实例没有记录 Cloud 服务的规格。
登录、查 trace 和摄入写入可以走同一组 Web Pod。扩容说明里的拆法,是把 /api/public/ingestion*、/api/public/media*、/api/public/otel* 分到另一套 Web。这套实例没有拆。摄入把这组 Pod 的 CPU 或内存打满时,页面和查询 API 一起变慢。
高可用挡住哪类故障
进程高可用靠每个 Deployment 至少两个副本、PodDisruptionBudget,以及按节点打散。数据高可用交给集群外的 RDS、Redis Serverless、S3 和 ClickHouse Cloud。集群里不再跑这四套存储。
公网入口和内网入口都只到同一个 Service,不是两套 Langfuse:
flowchart TD
  publicEntry["公网入口"] --> svc["langfuse-web Service"]
  privateEntry["内网入口"] --> svc
  svc --> web["Web Pod"]
  web --> outside["集群外的四套存储"]
  worker["Worker 无 Service"]
两条 Ingress 的 class 都是 alb,target-type 都是 ip,路径都是 /,后端都是 Service langfuse-web 的 3000 端口。健康检查都是 GET /api/public/health。公网入口听 HTTP 80 和 HTTPS 443,80 转到 443。内网入口只听 HTTP 80。登录回调地址 NEXTAUTH_URL 固定为公网入口的名字,所以从内网打开页面时,登录往返仍走公网这个名字。
Service 是 ClusterIP,选择子是 app=web。Web 的存活探针是 GET /api/public/health,就绪探针是 GET /api/public/ready。初始延迟 20 秒,周期 10 秒,超时 5 秒,失败阈值 3。没有 startup 探针。未就绪的 Web 不会留在 Service 后面。
Worker 的存活探针是 GET /api/health。没有就绪探针,也没有 Service。少一个 Worker 时,没有入口会把流量送进一个还没就绪的 Pod;另一个副本继续从同一条 Redis 队列取任务。
副本、打散和托管存储各挡一类故障。可用区不是硬约束:
flowchart TD
  entry["两条入口"] --> web["Web 至少两副本"]
  web --> pdb["PDB 至少留一个"]
  web --> host["按节点打散"]
  web --> queue["同一条 Redis 队列"]
  queue --> worker["Worker 至少两副本"]
  worker --> host
  web --> managed["RDS、Redis、S3、ClickHouse Cloud"]
  worker --> managed
  zone["可用区 ScheduleAnyway"] -.-> web
  zone -.-> worker
观察时 Web 和 Worker 都是 2 个副本。资源请求是 500m CPU、2Gi 内存,限制是 2 CPU、4Gi。滚动更新的 maxSurge 和 maxUnavailable 都是 25%。
HPA 只看 CPU,目标是请求的 70%,也就是 350m。minReplicas 是 2,maxReplicas 是 4。对象里没有 behavior。KEDA 和 VPA 关着。观察时利用率只有请求的几个百分点,副本停在 2。
PDB langfuse-web-pdb 和 langfuse-worker-pdb 的 minAvailable 都是 1。主动驱逐时,每个 Deployment 至少留一个 Pod。
拓扑约束按 hostname 和 zone 各一条,maxSkew 都是 1。hostname 不满足时 DoNotSchedule,zone 不满足时 ScheduleAnyway。打散按各自的 Deployment 计算,不要求 Web 和 Worker 互相避开。观察时两个 Web 不在同一节点,两个 Worker 也不在同一节点;有一台节点上同时有一个 Web 和一个 Worker。四个 Pod 都在同一个可用区。
| 失败 | 这套实例怎么挡 | 仍然叠在一起的部分 |
|---|---|---|
| 一个 Web Pod 不可用 | 另一副本在不同节点。未就绪 Pod 不进 Service。PDB 在主动驱逐时留一个 | 两个 Web 同时不可用时,入口没有后端 |
| 一个 Worker Pod 在取任务之后退出 | 另一副本继续消费同一条队列。HTTP 返回前,原始事件已经在 S3 | 队列里还没取走的引用要等剩余副本 |
| 一台节点不可用 | 同一 Deployment 的两个 Pod 被 hostname 约束分开 | 这台节点上若同时有 Web 和 Worker,两种进程各少一个副本 |
| 滚动发布 | maxSurge 和 maxUnavailable 都是 25% |
发布窗口里新旧 Pod 共用同一个请求上限 |
| CPU 升高 | HPA 可以把该 Deployment 从 2 扩到 4 | 只剩一个副本时,上限是限制值 2 CPU / 4Gi,不是请求值 500m / 2Gi |
| 整个可用区不可用 | zone 约束存在,但不强制 | ScheduleAnyway,且观察时四个 Pod 都在同一个可用区 |
| RDS、Redis、S3 或 ClickHouse 不可用 | 这四套在集群外,由各自的托管服务负责 | chart 里没有第二套集群内存储可以接过写入 |
| 摄入流量升高 | 尖峰先变成 Redis 队列深度,而不是立刻打满 ClickHouse | 登录和查询共用这组 Web。队列变长本身不会增加副本,见下一节 |
官方容器最低配置是 Web 和 Worker 各 2 CPU、4Gi 内存。这套实例的限制与这个数相同,请求低于这个数。HPA 按请求的 70% 触发,官方另有一个经验:2 CPU 的容器负载超过 50% 就可以加副本。两个阈值不是同一个 CPU 数。350m 就会开始扩容;官方那个 50% 指的是 2 CPU 容器上的 1 CPU。
容量先看队列还是 CPU
摄入变多时,先变长的是队列,不是 ClickHouse 的连接数。现网 HPA 看不到这个深度:
flowchart LR
  spike["摄入变多"] --> depth["队列 waiting 深度"]
  cpu["CPU 超过请求的 70%"] --> hpa["副本从 2 到 4"]
  depth -.-> skipped["未接入这套 HPA"]
官方用 Worker 的 CPU 做常规扩容,并用 StatsD 指标 langfuse.queue.ingestion.depth、标签 type:waiting 做队列扩容。从 Langfuse 3.170.0 起,发到 CloudWatch 时这条序列的名字是 langfuse.queue.ingestion.depth.type_waiting,开关是 ENABLE_AWS_CLOUDWATCH_METRIC_PUBLISHING。这套实例没有设置这个开关。两个 HPA 只看 CPU。队列积压本身不会把 Worker 从 2 扩到 4。
合并时的 ClickHouse 读仍在,扩容说明把这记成吞吐上限的一个来源。跳过它的条件写在上一节。另外,队列分片变量 LANGFUSE_INGESTION_QUEUE_SHARD_COUNT 和 LANGFUSE_TRACE_UPSERT_QUEUE_SHARD_COUNT 都没有设置,分片数用镜像里的默认值。官方把分片当作 Redis CPU 已经很高时的后一步:先把 Redis 放到至少 4 CPU 并打开集群模式,仍超过 90% 再分片。一旦调大,不要再调小。处理并发按分片计算,官方默认目标是每个 Worker 20。这套 Redis 已经是集群模式。
S3 的并发读和并发写都是 50。官方默认写并发是 50。写并发耗尽时,处理摄入和媒体的 Web 内存会涨,日志里会出现 socket 容量打满。再调大 LANGFUSE_S3_CONCURRENT_WRITES 时,官方要求逐级加,并同时看内存。
S3 用访问密钥,不用 Pod 身份。ServiceAccount langfuse 的 automountServiceAccountToken 是 false,注解里没有 IRSA。命名空间里没有 NetworkPolicy。这两条是访问边界,不是高可用手段。